Perguntas Frequentes
Meus testes estão muito lentos
Quando você está usando este @wdio/ocr-service, você não o utiliza para acelerar seus testes, mas porque tem dificuldade em localizar elementos em sua aplicação web/mobile e deseja uma maneira mais fácil de localizá-los. E todos nós esperamos saber que quando queremos algo, perdemos outra coisa. Mas..., existe uma maneira de fazer o @wdio/ocr-service executar mais rapidamente que o normal. Mais informações sobre isso podem ser encontradas aqui.
Posso usar os comandos deste serviço com os comandos/seletores padrão do WebdriverIO?
Sim, você pode combinar os comandos para tornar seu script ainda mais poderoso! A recomendação é usar os comandos/seletores padrão do WebdriverIO o máximo possível e usar este serviço apenas quando não conseguir encontrar um seletor único, ou quando seu seletor se tornar muito frágil.
Meu texto não é encontrado, como isso é possível?
Primeiro, é importante entender como o processo de OCR neste módulo funciona, então por favor leia esta página. Se você ainda não conseguir encontrar seu texto, pode tentar as seguintes coisas.
A área da imagem é muito grande
Quando o módulo precisa processar uma grande área da captura de tela, ele pode não encontrar o texto. Você pode fornecer uma área menor fornecendo um haystack quando usar um comando. Por favor, verifique os comandos que suportam o fornecimento de um haystack.
O contraste entre o texto e o fundo não está correto
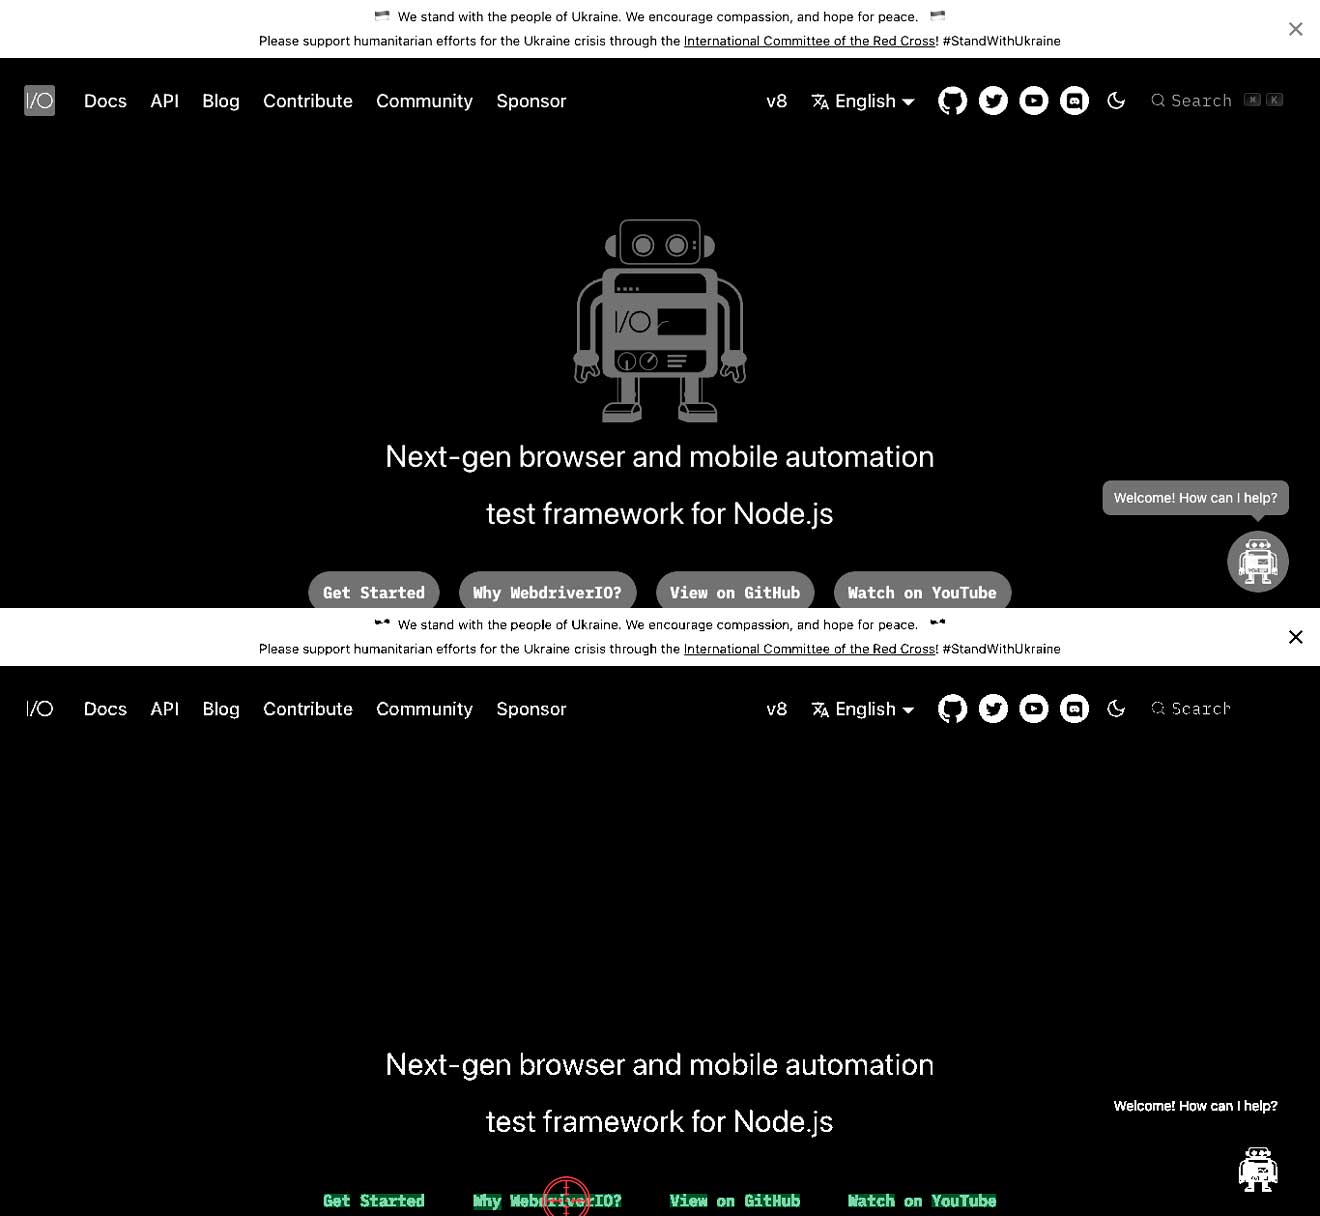
Isso significa que você pode ter texto claro em um fundo branco ou texto escuro em um fundo escuro. Isso pode resultar em não ser capaz de encontrar o texto. Nos exemplos abaixo, você pode ver que o texto Why WebdriverIO? é branco e está cercado por um botão cinza. Neste caso, resultará em não encontrar o texto Why WebdriverIO?. Ao aumentar o contraste para o comando específico, ele encontra o texto e pode clicar nele, veja a segunda imagem.
await driver.ocrClickOnText({
    haystack: { height: 44, width: 1108, x: 129, y: 590 },
    text: "WebdriverIO?",
    // // Com o contraste padrão de 0,25, o texto não é encontrado
    contrast: 1,
});
Por que meu elemento está sendo clicado, mas o teclado nos meus dispositivos móveis nunca aparece?
Isso pode acontecer em alguns campos de texto onde o clique é determinado como muito longo e considerado um toque longo. Você pode usar a opção clickDuration em ocrClickOnText e ocrSetValue para aliviar isso. Veja aqui.
Este módulo pode fornecer vários elementos de volta como o WebdriverIO normalmente pode fazer?
Não, isso atualmente não é possível. Se o módulo encontrar vários elementos que correspondam ao seletor fornecido, ele automaticamente encontrará o elemento que tem a maior pontuação de correspondência.
Posso automatizar completamente meu aplicativo com os comandos OCR fornecidos por este serviço?
Eu nunca fiz isso, mas em teoria, deve ser possível. Por favor, nos avise se você conseguir isso ☺️.
Vejo um arquivo extra chamado {languageCode}.traineddata sendo adicionado, o que é isso?
{languageCode}.traineddata é um arquivo de dados de idioma usado pelo Tesseract. Ele contém os dados de treinamento para o idioma selecionado, que inclui as informações necessárias para que o Tesseract reconheça caracteres e palavras em inglês de forma eficaz.
Conteúdo de {languageCode}.traineddata
O arquivo geralmente contém:
- Dados do Conjunto de Caracteres: Informações sobre os caracteres no idioma inglês.
- Modelo de Linguagem: Um modelo estatístico de como os caracteres formam palavras e as palavras formam frases.
- Extratores de Características: Dados sobre como extrair características de imagens para o reconhecimento de caracteres.
- Dados de Treinamento: Dados derivados do treinamento do Tesseract em um grande conjunto de imagens de texto em inglês.
Por que o {languageCode}.traineddata é importante?
- Reconhecimento de Idioma: O Tesseract depende desses arquivos de dados treinados para reconhecer e processar com precisão o texto em um idioma específico. Sem
{languageCode}.traineddata, o Tesseract não seria capaz de reconhecer texto em inglês. - Desempenho: A qualidade e precisão do OCR estão diretamente relacionadas à qualidade dos dados de treinamento. Usar o arquivo de dados treinados correto garante que o processo de OCR seja o mais preciso possível.
- Compatibilidade: Garantir que o arquivo
{languageCode}.traineddataesteja incluído em seu projeto, tornando mais fácil replicar o ambiente OCR em diferentes sistemas ou máquinas dos membros da equipe.
Versionando {languageCode}.traineddata
Incluir {languageCode}.traineddata em seu sistema de controle de versão é recomendado pelas seguintes razões:
- Consistência: Garante que todos os membros da equipe ou ambientes de implantação usem exatamente a mesma versão dos dados de treinamento, levando a resultados de OCR consistentes em diferentes ambientes.
- Reprodutibilidade: Armazenar este arquivo no controle de versão facilita a reprodução de resultados ao executar o processo de OCR em uma data posterior ou em uma máquina diferente.
- Gerenciamento de Dependências: Incluí-lo no sistema de controle de versão ajuda no gerenciamento de dependências e garante que qualquer configuração ou configuração de ambiente inclua os arquivos necessários para que o projeto seja executado corretamente.
Existe uma maneira fácil de ver qual texto é encontrado na minha tela sem executar um teste?
Sim, você pode usar nosso assistente CLI para isso. A documentação pode ser encontrada aqui
